

1. grep
作用:文本搜索工具,根据用户指定的“模式”对目标文本逐行进行匹配检查;打印匹配到的行
模式:由正则表达式字符及文本字符所编写的过滤条件
–color=auto: 对匹配到的文本着色显示
-v: 显示不被pattern匹配到的行
-i: 忽略字符大小写
-n:显示匹配的行号
-c: 统计匹配的行数
-o: 仅显示匹配到的字符串
-q: 静默模式,不输出任何信息
-A #: after, 后#行
-B #: before, 前#行
-C #:context, 前后各#行
-e:实现多个选项间的逻辑or关系
grep –e ‘cat ’ -e ‘dog’ file
-w:匹配整个单词
-E:使用ERE
-F:相当于fgrep,不支持正则表达式
2.文件查看命令:cat
cat [OPTION]… [FILE]…
-E: 显示行结束符$
-n: 对显示出的每一行进行编号
-A:显示所有控制符
-b:非空行编号
-s:压缩连续的空行成一行
文本统计工具 wc sort uniq
wc计数单词总数、行总数、字节总数和字符总数
可以对文件或STDIN中的数据运行
wcstory.txt
39 237 1901 story.txt
行数 字数 字节数
常用选项
-l只计数行数
-w只计数单词总数
-c只计数字节总数
-m只计数字符总数
-L显示文件中最长行的长度
文本排序sort把整理过的文本显示在STDOUT,不改变原始文件
sort[options]file(s)
常用选项
-r执行反方向(由上至下)整理
-n执行按数字大小整理
-f选项忽略(fold)字符串中的字符大小写
-u选项(独特,unique)删除输出中的重复行
-t c选项使用c做为字段界定符
-k X选项按照使用c字符分隔的X列来整理能够使用多次
uniq命令:从输入中删除前后相接的重复的行
uniq[OPTION]… [FILE]…
-c: 显示每行重复出现的次数
-d: 仅显示重复过的行
-u: 仅显示不曾重复的行
连续且完全相同方为重复
常和sort 命令一起配合使用:
sort userlist.txt | uniq-c
cut [OPTION]… [FILE]…
-d DELIMITER: 指明分隔符,默认tab
-f FILEDS:#: 第#个字段
#,#[,#]:离散的多个字段,例如1,3,6
#-#:连续的多个字段, 例如1-6
混合使用:1-3,7
-c按字符切割
–output-delimiter=STRING指定输出分隔符
正则表达式
由一类特殊字符及文本字符所编写的模式,其中有些字符(元字符)不表示字符字面意义,而表示控制或通配的功能
程序支持:grep,sed,awk,vim, less,nginx,varnish等
分两类:
基本正则表达式:BRE
扩展正则表达式:ERE
grep -E, egrep
正则表达式引擎:
采用不同算法,检查处理正则表达式的软件模块
PCRE(Perl Compatible Regular Expressions)
元字符分类:字符匹配、匹配次数、位置锚定、分组
字符匹配:
. 匹配任意单个字符
[] 匹配指定范围内的任意单个字符
[^] 匹配指定范围外的任意单个字符
[:alnum:] 字母和数字
[:alpha:] 代表任何英文大小写字符,亦即A-Z, a-z
[:lower:] 小写字母[:upper:] 大写字母
[:blank:] 空白字符(空格和制表符)
[:space:]水平和垂直的空白字符(比[:blank:]包含的范围广)
[:cntrl:] 不可打印的控制字符(退格、删除、警铃…)
[:digit:] 十进制数字[:xdigit:]十六进制数字
[:graph:] 可打印的非空白字符
[:print:] 可打印字符
[:punct:] 标点符号
匹配次数:用在要指定次数的字符后面,用于指定前面的字符要出现的次数
* 匹配前面的字符任意次,包括0次
贪婪模式:尽可能长的匹配
.*任意长度的任意字符
\?匹配其前面的字符0或1次
\+匹配其前面的字符至少1次
\{n\}匹配前面的字符n次
\{m,n\}匹配前面的字符至少m次,至多n次
\{,n\}匹配前面的字符至多n次
\{n,\}匹配前面的字符至少n次
位置锚定:定位出现的位置
^ 行首锚定,用于模式的最左侧
$ 行尾锚定,用于模式的最右侧
^PATTERN$ 用于模式匹配整行
^$ 空行
^[[:space:]]*$ 空白行
\< 或\b词首锚定,用于单词模式的左侧
\> 或\b词尾锚定;用于单词模式的右侧
\<PATTERN\>匹配整个单词
分组:\(\) 将一个或多个字符捆绑在一起,当作一个整体进行处理,如:\(root\)\+
分组括号中的模式匹配到的内容会被正则表达式引擎记录于内部的变量中,这些变量的命名方式为: \1, \2, \3, …
\1表示从左侧起第一个左括号以及与之匹配右括号之间的模式所匹配到的字符
示例:\(string1\+\(string2\)*\)
\1 :string1\+\(string2\)*
\2 :string2
后向引用:引用前面的分组括号中的模式所匹配字符,而非模式本身
或者:\|
示例:a\|b: a或b C\|cat: C或cat \(C\|c\)at:Cat或cat
综合以上所有具体事例
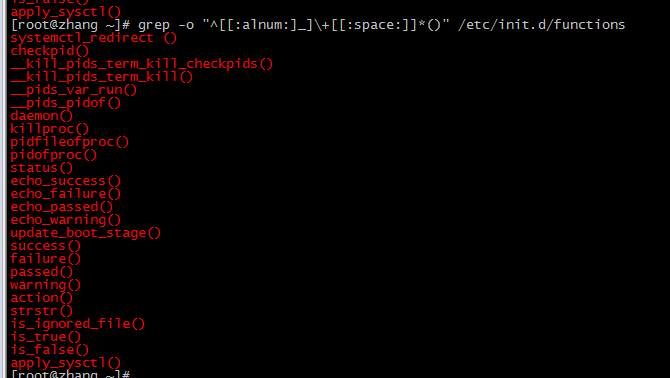
取函数名

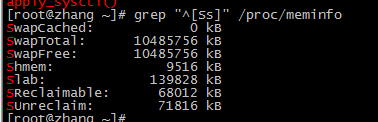
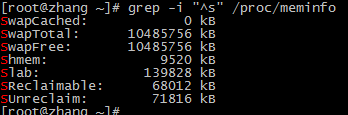
显示/proc/meminfo文件中以大小s开头的行
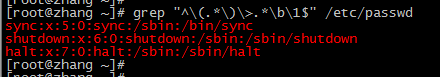
找出“netstat -tan”命令的结果中以‘LISTEN’后跟任意多个空白字符结尾的行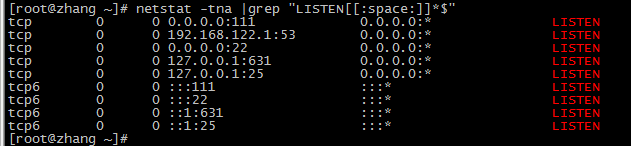
添加用户bash、testbash、basher、sh、nologin(其shell为/sbin/nologin),找出/etc/passwd用户名同shell名的行
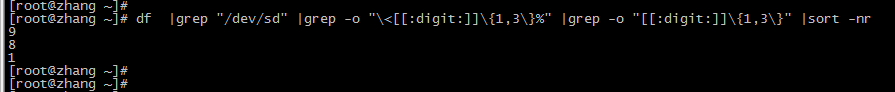
利用df和grep,取出磁盘各分区利用率,并从大到小排序
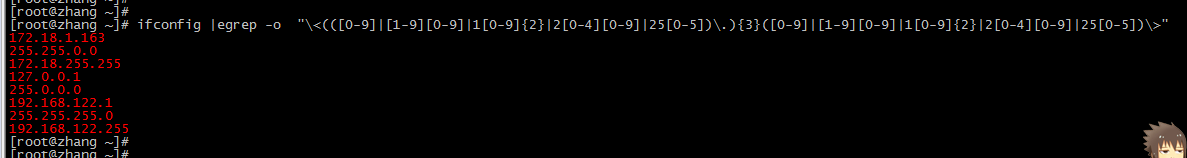
显示ifconfig命令结果中所有IPv4地址
本文来自投稿,不代表Linux运维部落立场,如若转载,请注明出处:http://www.178linux.com/88853

