

grep与正则表达式

一、grep

       grep常用于文本搜索。通过自定义的模式(pattern),筛选出使用者需要的文本内容。除了有grep,还有egrep和fgrep。其中egrep = grep  –E,而fgrep则是不支持正则表达式。

       grep语法:grep [option] pattern [file] 

       常用option如下:

              -i:忽略字符的大小

              -n:显示匹配的行号

              -c:统计匹配的行数

              -o:只显示匹配到的内容

              -q:静默模式,不显示出任何信息

              -e:实现多个选项的or的关系

              -w:匹配整个单词

              -v:显示除pattern外的内容

              -F:相当于fgrep

              -E:相当于egrep

二、正则表达式

       1、匹配字符:

              .     匹配任意单个字符

              []    匹配中括号内指定范围的任意单个字符

              [^]   匹配中括号指定范围外的任意单个字符

              [:alnum:] 匹配字母和数字

              [:alpha:]  匹配任何英文

              [:lower:]  小写英文字母

              [:upper:]  大写英文字母

              [:blank:]  空白字符(空格和字表符)

              [:space:]  水平和垂直的空白字符(范围比blank的广)

              [:cntrl:]   不可打印的控制字符(退格、删除、警铃等)

              [:digit:]   十进制数字

              [:xdigit:]  十六进制数字

              [:graph:]  可打印的非空白字符

              [:print:]   可打印的字符

              [:punct:]  标点符号

       2、匹配次数:

              *  匹配前面的字符任意次,包括0次。

              \?   匹配前面的字符0或1次

              \+   匹配前面的字符至少一次

              \{n\} 匹配前面的字符n次

              \{m,n\} 匹配前面的字符从m到n次

              \{,n\}  匹配前面的字符至多n次

              \{n,\}  匹配前面的字符至少n次

      3、定位

              ^ 定位行首,处于pattern的最左侧

              $ 定位行尾,用于pattern的最右侧

              \<或\b 词首,用于pattern中单词的左侧

              \>或\b 词尾,用于pattern中单词的右侧

              \<pattern\> 匹配整个单词

       4、分组

              \( \)将一个或多个字符捆绑在一起,当作一个整体进行处理。

三、小结

       通过一和二的简单介绍,现在将两者结合在一起,并把学习后得到的一些理解写下来。

1、pattern可以直接为想要得到的内容,如图1。

grep与正则表达式

图1

2、[ ]中括号里表示的是匹配的内容的范围,用此括号匹配的结果是一个字符。比如[a-d]表示的是英文abcd这个范围。[ ]不只表示一种范围、内容,可以有多种,比如[a-z[:punct:]0-9]表示的是标点符号、英文字母a至z还有数字0-9。但是没有[0-10]或者是[0-100]等类似的范围,因为在pattern中把需要被过滤的内容都当作字符,而内容中的数字也被拆成一个个字符,没有大小可言,简单点说就是100其实是三个字符1、0、0。还有,单独用类似上文“二”中的[:digit:]这样的内容是会出错的,需要在[:digit:]外再加一个中括号才能表示匹配得到的是一个在digit范围内的字符,如图2。
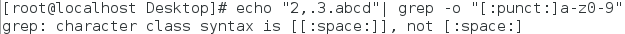
grep与正则表达式

图2

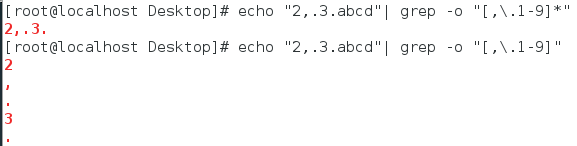
3、再次强调一点,[ ]表示的是匹配得到一个字符,是一个。因此,需要得到多个字符,得用上文
“二”的第二点知识,如图3。
grep与正则表达式

图3

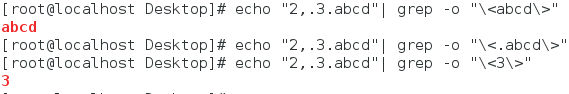
4、\< \>中间括起来的可以为英文和数字,但是不能是别的标点符号,如图4。
grep与正则表达式

图4

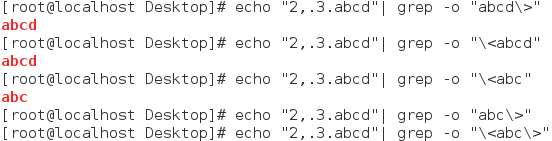
“\<\>”和“\>”是把一串连续的英文数字当作整体,而“\<”不是,如图5最后两个命令都匹配不到内容,是因为“\<\>”和“\>”认为存在abcd但不存在abc。
grep与正则表达式

图5

5、\(和\)必须成对出现,并且他们被当作一个整体进行处理,并且分组括号中的模式匹配到的内容会被正则表达式引擎记录于内部的变量,命名方式:\1,\2,\3…

示例:\(string1\+\(string2\)*\)

\1:string1\+\(string2\)*

\2:string2

6、 grep –E 作用:除了\<和\>,其他的例如{ }、( ),没有添加-E时,\{\}表示范围,添加了-E选项后,直接{}表示范围。

原创文章,作者:Eminem,如若转载,请注明出处:http://www.178linux.com/83170

赞 (0)
EminemEminem
上一篇 2017-07-29 17:27
下一篇 2017-07-29 17:41

相关推荐

  • 解决线上服务器httpd无法反向代理resin的解决方法

    一、简述   前两天有后端的小伙伴跟我反映说使用httpd反向代理resin时遇到的问题,在做网站管理后台的时候,发起的http的put,delete的请求无法经由resin传递到后面的dbserver。当时的第一反应就是httpd的反向代理设置出现的问题,但是关于httpd反代resin的内容在网上机会搜索不到。于是,查看httpd反代tomca…

    Linux干货 2017-01-11
  • Linux Sysadmin–part1

    一、创建一个10G分区,并格式为ext4文件系统; 1、要求其block大小为2048,预留空间百分比为2,卷标为MYDATA,默认挂载属性包含acl; 2、挂载至/data/mydata目录,要求挂载时禁止程序自动运行,且不更新文件的访问时间戳; ###创建10G分区 ~]# fdisk /dev/sdb Command (m for help): n P…

    2017-09-04
  • SElinux

    selinux  配置文件 修改   就要重启 targeted:用来保护常见的网路服务,仅有限进程受到selinux控制,只监控容易被入侵的进程。 targeted  慢慢完善的法律 系统默认使用   targeted     CENTOS6 CENTOS7 ZAI &nbsp…

    Linux干货 2016-09-14
  • Linux文本搜索工具grep

    Linux文本搜索工具grep Linux文本搜索工具grep grep 基本正则表达式 egrep 扩展正则表达式 fgrep 简介 grep(全称Globally search a Regular Expression and Print,全面搜索正则表达式并把行打印出来)是一种强大的文本搜索工具,根据用户指定的“模式(pattern)”对目标文本进行匹…

    2016-04-05
  • Linux学习总结及练习&day08-sed文本处理工具

    第一部分、Linux文本处理三剑客之sed(Stream EDitor)文本编辑工具     一、sed的基本功能工作原理     sed是一种流编辑器,它一次处理一行内容。处理时,把当前处理的行存储在临时缓冲区中,称为“模式空间”(pattern space),接着用sed命令…

    Linux干货 2016-08-10
  • 马哥教育网络班21期+第7周课程练习

    马哥教育网络班21期+第7周课程练习 创建一个10G分区,并格式为ext4文件系统;    a.要求block大小为2048,预留空间百分比为2,卷标为MYDATA,默认挂载属性包含acl;    b.挂载至/data/mydata目录,要求挂载时禁止程序自动运行,且不能更新文件的访问时间戳; #&…

    Linux干货 2016-08-22
