正则表达式的概念和用法

概念

正则表达式是对字符串操作的一种逻辑表达方式,很多情况下我们需要在茫众多的文件中找到我们需要的文件时,就需要用到正则表达式了

正则表达式就如同一个过滤器,能够筛选出希望得到的字符串。它可以检索、替换符合我们自己规定格式的所有文本。

  • 正则表达式分两类:

    • 基本正则表达式
    • 扩展正则表达式

正则表达式的用法和选项

在Linux中,正则表达式通常会配合文本过滤工具grep使用。

  • grep的功能强大,且简单粗暴。

正则表达式的概念和用法 

正则表达式的概念和用法

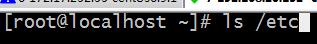
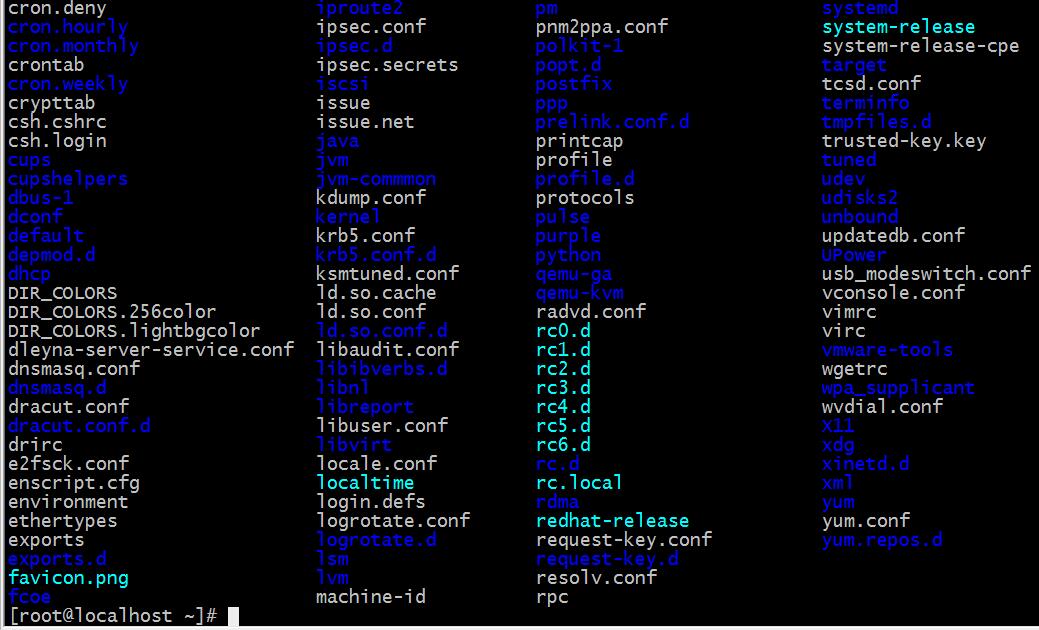
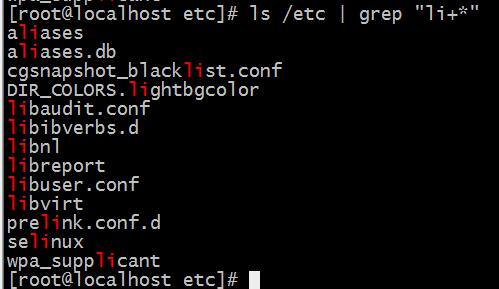
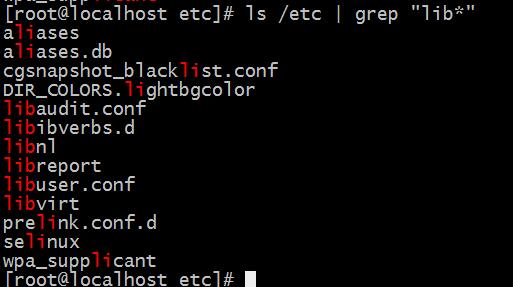
以/etc目录为例

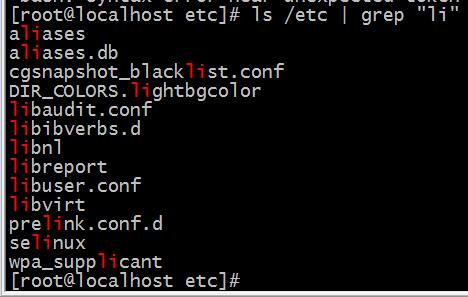
我们用grep来筛选一下其中含有”li”的文件


正则表达式的概念和用法

这是利用grep在/etc中对字母”li”进行筛选

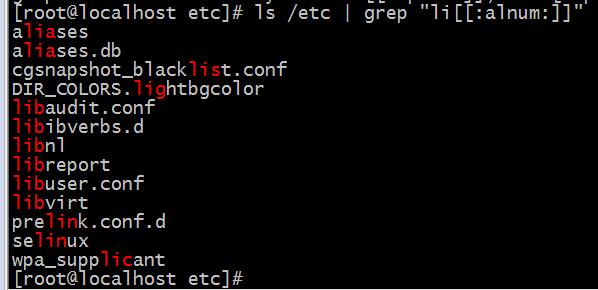
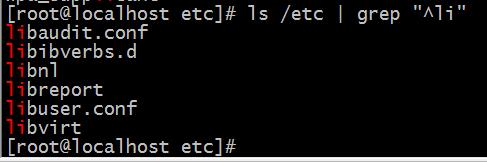
如果我们只想要以”li”为首字母的文件要怎么做呢?
这就需要用到正则表达式了
正则表达式的概念和用法

可以看到依靠正则表达式能很轻松的达到我们想要的结果。

正则表达式还有更多更强大的功能,让我们来了解一下吧。

  • 正则表达式
    正则表达式的元字符分类:匹配字符、匹配字数、位置锚定、分组

    • 字符匹配:

      匹配任意单个字符
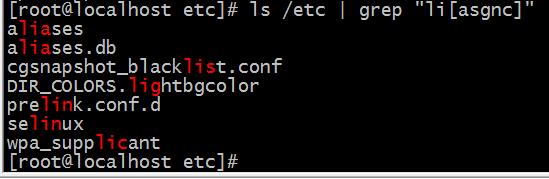
      []              匹配指定范围内的任意单个字符
      [^]             匹配指定范围外的任意单个字符
      [[:alnum:]]     字母和数字
      [[:alpha:]]     代表任何英文大小写字符,亦即 A-Z, a-z
      [[:lower:]]     小写字母 
      [[:upper:]]     大写字母
      [[:blank:]]     空白字符(空格和制表符) 
      [[:digit:]]     十进制数字
      [[:xdigit:]]    十六进制数字
      [[:graph:]]     可打印的非空白字符
      [[:print:]]     可打印字符
      [[:punct:]]     标点符号
    • 正则表达式的概念和用法

      正则表达式的概念和用法


    • 匹配字数(””为转译符,防止系统将某些字符当命令处理)

      \*      匹配前面的字符任意次,包括0次
      
      \+      匹配前面的字符1次以上,不包括0次
      
      *?      匹配前面任意次,但尽可能少重复
      
      .*      任意长度的任意字符
      
      \?      匹配其前面的字符0或1次
      
      \+      匹配其前面的字符至少1次
      
      \{n\}   匹配前面的字符n次
      
      \{m,n\} 匹配前面的字符至少m次,至多n次
      
      \{,n\}  匹配前面的字符至多n次
      
      \{n,\}  匹配前面的字符至少n次
    • 正则表达式的概念和用法

      正则表达式的概念和用法

    • 位置锚定 :

      ^   行首锚定,用于模式的最左侧
      
      $   行尾锚定,用于模式的最右侧
      
      \< 或 \b     词首锚定,用于单词模式的左侧
      
      \> 或 \b     词尾锚定;用于单词模式的右侧
      
      \<PATTERN\> 匹配整个单词
    • 分组

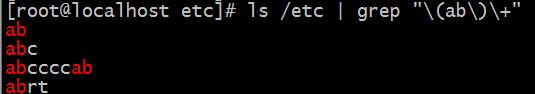
      分组 : \(\) 将一个或多个字符捆绑在一起,当作一个整体进行处理,如 : \(root\)+

      后向引用 : 引用前面的分组括号中的模式所匹配字符,而非模式本身

      或者 : \|
    • 正则表达式的概念和用法

  • 扩展正则表达式
    扩展正则表达式是正则表达式的优化版,元字符的表达更简洁,更方便。
    在grep中需要加选项 “-e” 来启用扩展正则表达式或egrep(=grep -e)

    • 在字符匹配中的双中括号在扩展正则表达式中可以简写为一个

      [ : alnum : ]   字母和数字
      [ : alpha : ]   代表任何英文大小写字符,亦即 A-Z, a-z
      [ : lower : ]   小写字母 
      [ : upper : ]   大写字母
      [ : blank : ]   空白字符(空格和制表符) 
      [ : digit : ]   十进制数字
      [ : xdigit : ]  十六进制数字
      [ : graph : ]   可打印的非空白字符
      [ : print : ]   可打印字符
      [ : punct : ]   标点符号
    • 大部分转译符(\)可以省略 :

      *: 匹配前面字符任意次
      
      ? : 0或1次
      
      +: 1次或多次
      
      {m} : 匹配m次
      
      {m,n} : 至少m,至多n次
      
      a|b : a或b
      
      C|cat : C或cat
      
      (C|c)at : Cat或cat

总结

正则表达式的功能很强大且很好用,理解上也可能对于字符表达的含义会有些混乱需要多用多记才能熟练掌握。

原创文章,作者:kstg5663294,如若转载,请注明出处:http://www.178linux.com/77818

赞 (0)
kstg5663294kstg5663294
上一篇 2017-06-10 15:49
下一篇 2017-06-11 12:28

相关推荐

  • raid介绍及逻辑卷与逻辑卷快照应用

    高级文件系统管理 配置配额系统 综述 在内核中执行,以文件系统为单位启用,对不同组或者用户的策略不同,如将home单独分区,但是并不意味着每个用户都可以无上限使用该分区的空间,所以系统管理员要据块或者节点进行限制,限制每个用户使用磁盘的空间,当到达执行软限制( soft limit  )  会警报提醒用户;当硬限制( hard limit…

    Linux干货 2016-09-02
  • 浅谈linux基础知识(二)

    1、Linux上的文件管理类命令都有哪些,其常用的使用方法及其相关示例演示 文件管理工具:cp,mv,rm cp命令:copy 源文件,目标文件 单源复制:cp[OPTION]… [-T] SOURCE DEST 多源复制: cp[OPTION]… SOURCE… DIRECTORY cp[OPT…

    Linux干货 2016-10-12
  • linux基础知识:计算机的组成及其功能

    摘要:
    1. 描述计算机的组成及其功能。
    2. 按系列罗列Linux的发行版,并描述不同发行版之间的联系与区别。
    3. 描述Linux的哲学思想,按照自己的理解对其解释性描述。
    4. 说明Linux系统上命令的使用格式;详细介绍ifconfig、echo、……等命令使用,配合相应实例阐述。
    5. 如何获取帮助信息,描述man文档章节划分。
    6. 罗列发行版基础目录名称命名法则及功用规定。

    2017-12-03
  • 分区管理

    分区管理     一.磁盘分类 机械硬盘(HDD):该硬盘是传统的普通硬盘。主要有:盘片,磁头,盘片转轴及控制电机,磁头控制器,数据转换器,接口,缓存等几个部分组成  固态硬盘(SSD):用固态电子存储芯片阵列而制成的硬盘,由控制单元和存储单元组成。 二.特点 1.     &n…

    Linux干货 2017-08-20
  • btrfs初步应用

    前言 一种技术要知其然,还要知其所以然。 Btrfs文件系统 Btrfs(B-tree文件系统,通常念成Butter FS,Better FS或B-tree FS),一种支持写入时复制(COW)的文件系统,运行在Linux操作系统,采用GPL授权。Oracle于2007年对外宣布这项计划,并发布源代码,在2014年8月发布稳定版目标是替换Linux目前的ex…

    Linux干货 2016-05-22
  • N22-第六周博客作业

    请详细总结vim编辑器的使用并完成以下练习题 1、复制/etc/rc.d/rc.sysinit文件至/tmp目录,将/tmp/rc.sysinit文件中的以至少一个空白字符开头的行的行首加#; :%s@^[[:space:]]\+[^[:space:]]@#\1@g 或 :%s@^[[:space:]]\+[^[:space:]]@#&a…

    Linux干货 2016-09-26