文本处理工具之grep

                文本处理工具之grep

一、grep的简介

1、grep是一个文本过滤器的工具,它根据用户指定的模式(pattern)对目标文本进行匹配检查,并将匹配的行打印到标准输出或输出重定向。

2、模式:由文本字符或正则表达式组成

3、正则表达式分两类:

       基本正则表达式

       扩展正则表达式

二、grep工具

grep的基本语法

grep  [OPTIONS]  PATTERN  [FILE…]

选项:

    -i:忽略字符大小写

    -v:显示不能被模式匹配的行

    -o:仅显示匹配的字符串

    -q:静默模式,不输出任何信息(多用于脚本)

    -c:显示统计到的行数,等同于wc -l

    -e:指定多个搜索条件

    -A #:匹配到的后#行

    -B #:匹配到的前#行

    -C #:匹配到的前后个#行

    -E :是扩展正表达式   

    -n :表示显示行号

三、基本正则表达式的元字符

    1、字符匹配:

       . :任意单个字符

       [] :匹配范围内任意单个字符,(如:[abc]表示可以是a 或b或c中的任意一个)

       [^]:匹配范围外的任意单个字符

       几种常用的特殊的字符集:

       [:alnum:] 数字和字符

       [:alpha:] 英文大小写字符 a-z A-Z

       [:lower:] 小写字母

       [:upper:] 大写字母

       [:space:] 专门匹配空格

       [:digit:] 十进制数字

       [:xdigit:]十六进制数字

       [:punct:] 标点符号

2、次数匹配

       * :表是其前字符任意次

       \?:表示其前字符0次或一次

       \+:表示其前字符至少一次

       \{m\}:表示其前字符m次

       \{m,n\}:表示其前字符至少m最多n次

       \{0,n\}:表示其前字符最多n次

       \{m,\}:表示其前字符至少m次

3、位置锚定:

   ^ :锚定行首 (如:“^root”表示以“root”字符串作为行的开头)

   $ :锚定行尾 (如:“root$”表示以“root”字符串作为行的行尾)

   \<或\b:词首锚定

       \>或\b:词尾锚定

       ^$:表示空行,但不包含空白字符

       ^[[:space:]]*$:表示空行,包含空白字符

       \<PATTERN\>等同于\bPATTERN\b:表示匹配整个单词

4、分组

   \(\)

   分组是将一个或多个字符绑定在一起,当作一个整体来处理(比如后向引用:\1 \2 …)。

   示例  :\(adc\(xyz\)\)利用后向引用

         \1:表示第一个左括号以及与其匹配的右括号之间的匹配到的内容。本例中\1表示:abc\(xyz\)

         \2:表示第二个左括号以及与其匹配的右括号之间的匹配到的内容。本例中\1表示:xyz

5、基本正则表达式的使用

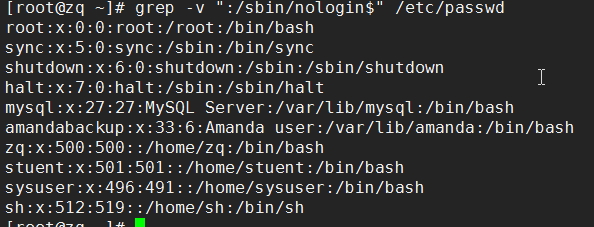
         (1)显示/etc/passwd中不以/sbin/nologin结尾的行
                文本处理工具之grep

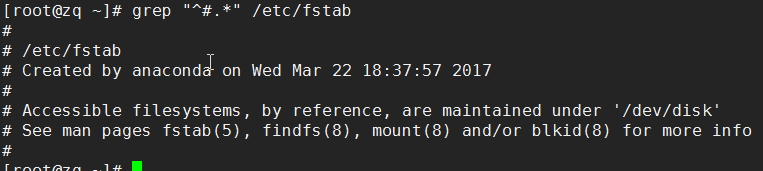
         (2) 显示/etc/fstab文件中以#号开头的行

                文本处理工具之grep

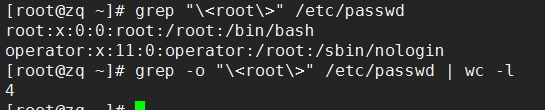
         (3)显示root单词在/etc/passwd的文件中出现的次数

                文本处理工具之grep

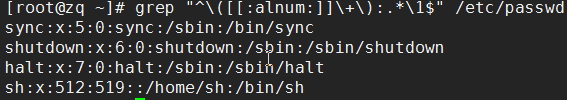
         (4)找出当前系统上用户名和其默认shell相同的用户

                文本处理工具之grep

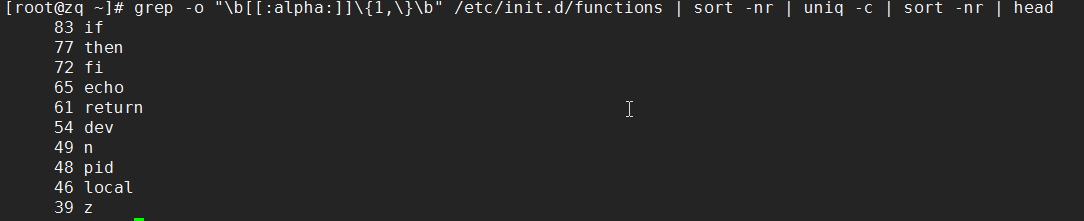
         (5)统计/etc/init.d/functions文件中每个单词出现的次数,并统计出前十名
                文本处理工具之grep

四、扩展正则表达式

     1、字符匹配:

       . :任意单个字符

       [] :匹配范围内任意单个字符,(如:[abc]表示可以是a 或b或c中的任意一个)

       [^]:匹配范围外的任意单个字符

     2、次数匹配

       * :表是其前字符任意次

       ?:表示其前字符0次或一次

       +:表示其前字符至少一次

       {m}:表示其前字符m次

       {m,n}:表示其前字符至少m最多n次

       {0,n}:表示其前字符最多n次

       {m,}:表示其前字符至少m次


     3、位置锚定

        扩展正则表达式中的位置锚定和基本正则表达式相同

     4、分组

        ():与基本正则表达式相比去掉了“\”转义,用法和基本正则表达式相同

     5、扩展正则表达式也可以用 “egrep”这个文本处理工具,它等同于 “grep -E”

        它俩的用法一致

     6、扩展正则表达式的使用

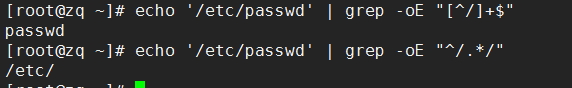
        (1)取出路径/etc/passwd的基名和路径名
                文本处理工具之grep

 (2)在/etc/passwd文件中以root开头行,并且行内至少再有一个root单词的行

          文本处理工具之grep


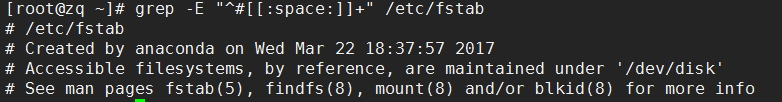
 (3)显示/etc/fstab 文件中以#开头其后跟了至少一个空白字符的行
                文本处理工具之grep


原创文章,作者:zq,如若转载,请注明出处:http://www.178linux.com/74857

赞 (0)
zqzq
上一篇 2017-05-06 19:46
下一篇 2017-05-06 22:11

相关推荐

  • 文本编辑工具Sed

                    Stream EDitor, 行编辑器         sed是一种流编辑器,它一次处理一行内容。处理时,一次性的先把文件读入内存中,并且开辟一块内存空间,该内存空间称为“模式空间”(pa…

    Linux干货 2016-08-10
  • 网络第21期第七周作业

    1、创建一个10G分区,并格式为ext4文件系统;    (1) 要求其block大小为2048, 预留空间百分比为2, 卷标为MYDATA, 默认挂载属性包含acl; [root@localhost ~]# fdisk /dev/sdb WARNING: DOS-compatible m…

    Linux干货 2016-10-09
  • 第五周作业

    1、显示当前系统上root、fedora或user1用户的默认shell; [root@localhost ~]# egrep '^(fedora|root|user1):' /etc/passwd |cut -d: -f1,7 root:/bin/bash user1…

    Linux干货 2017-02-04
  • 马哥教育网络班19期+第8周课程练习

    1、请描述网桥、集线器、二层交换机、三层交换机、路由器的功能、使用场景与区别。     网桥用来连接两个不同的网络间的设备;集线器的作用是把接受的信号放大,从另一个端口再穿法出去,说白了就是延长网络的传输距离;   二层交换机工作在数据链路层,根据源和目的MAC地址进行数据转发;三层交换机就是具有部分路由器功能的交换机,三层交换…

    Linux干货 2016-07-07
  • bash脚本编程class3

    bash脚本编程class3—函数定义与数组使用相关     一.函数的使用以及数组的定义   我们通过学习知道,当编辑一个shell脚本的时候,可以在这个shell脚本中调用其他的shell脚本来实现特定的功能。在实际工作环境中,用很多shell实现的功能是我们常常使用到的,如果一次一次的调用这些shell脚本会显得非常麻烦。…

    Linux干货 2016-08-24
  • 子网掩码快速划分-心算

    问题状况: 不管作为一名网络工程师还是一名运维工程师,快速心算划分出网络掩码是必备得技能,      为什么要进行子网掩码划分? 纯二层环境不能隔离广播 有安全 管理方面的问题 解决办法:在二层环境下增加三层设备 将原本的一个主类网络号划分成多个子网     掩码基础知识:     注意:此步没记住不要往下进行     死记硬背1:     2^0=1   …

    Linux干货 2017-03-26